Crawl Budget: Como Reduzir Desperdício e Acelerar a Indexação
O termo crawlbudget costuma aparecer nas auditorias de SEO apenas quando algo já está dando errado. Páginas que demoram a indexar, conteúdos novos que não entram…
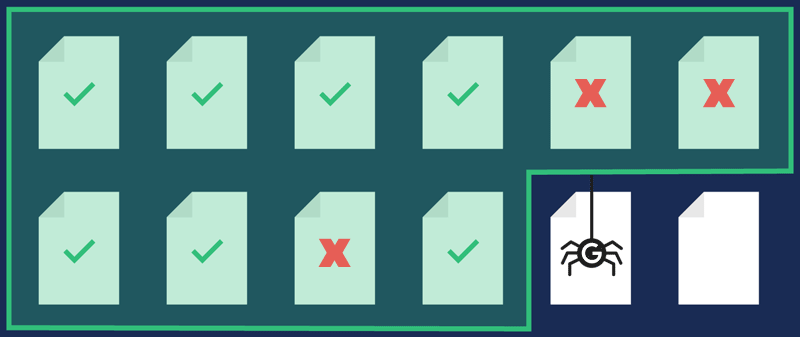
O termo crawlbudget costuma aparecer nas auditorias de SEO apenas quando algo já está dando errado. Páginas que demoram a indexar, conteúdos novos que não entram no índice, atualizações ignoradas pelo Google e um site que parece invisível apesar de tecnicamente “correto”. O problema é que o crawl budget não é um erro isolado, nem um ajuste fino avançado reservado a sites gigantes. Ele é uma consequência direta da forma como você estrutura, publica, conecta e mantém seu conteúdo ao longo do tempo.
Desde os primeiros mecanismos de busca, o rastreamento sempre foi um recurso limitado. No início da web, essa limitação era brutal: servidores lentos, banda escassa e um volume pequeno de páginas. Com a expansão da internet, o Google precisou criar sistemas inteligentes para decidir onde gastar tempo, processamento e requisições. O crawl budget nasce exatamente desse dilema: o Google não pode, nem quer, rastrear tudo o tempo todo.
Hoje, mesmo com infraestrutura massiva, o princípio continua o mesmo. Cada site recebe uma “atenção” proporcional ao seu histórico, autoridade, estabilidade técnica e valor percebido. Quando você cria milhares de URLs inúteis, mantém páginas fracas indexáveis ou constrói arquiteturas confusas, o Google não pune explicitamente. Ele simplesmente perde interesse. E quando o interesse diminui, a velocidade de indexação cai, a frequência de rastreamento despenca e o site entra em um ciclo silencioso de estagnação.
Entender crawl budget é entender como o Google pensa em escala. Não se trata de agradar o robô com truques técnicos, mas de mostrar, de forma consistente, que cada URL publicada merece existir, ser rastreada e atualizada. Quem domina isso acelera indexação, protege rankings e cria vantagem estrutural difícil de copiar.
Como o Google decide o crawl budget de um site
O Google nunca divulgou uma fórmula exata para cálculo de crawl budget, e isso não é por acaso. O sistema envolve múltiplas camadas de decisão que combinam sinais técnicos, históricos e comportamentais. Ainda assim, com anos de observação prática, patentes publicadas e testes controlados, é possível entender os pilares que realmente influenciam esse orçamento.
O primeiro componente é a capacidade de rastreamento. O Google avalia quanto seu servidor aguenta sem degradar a experiência. Sites lentos, com erros frequentes, timeouts ou respostas instáveis acabam tendo o ritmo de rastreamento reduzido automaticamente. Não é uma punição moral, é uma medida de autopreservação do próprio buscador.
O segundo fator é a demanda de rastreamento. Aqui entra o interesse do Google pelo seu conteúdo. URLs que recebem tráfego, têm links externos relevantes, histórico de atualização e sinais claros de utilidade tendem a ser rastreadas com mais frequência. Já páginas que nunca performaram, não recebem links e não mudam há anos começam a ser visitadas cada vez menos.
Existe ainda um terceiro elemento menos discutido, mas crucial: a confiança estrutural. Sites com arquitetura limpa, hierarquia clara, URLs consistentes e padrões previsíveis ajudam o Google a entender rapidamente o que é importante. Em contrapartida, estruturas caóticas, cheias de parâmetros, filtros e variações artificiais confundem o rastreador e diluem o crawl budget disponível.
Quando esses três fatores se alinham, o Google passa a rastrear com fluidez. Quando entram em conflito, o orçamento se torna escasso. E o detalhe mais perigoso é que esse processo é cumulativo. Pequenos desperdícios, ignorados por meses, se transformam em gargalos difíceis de reverter.
Crawl Budget e indexação: a relação que poucos analisam com profundidade
É comum ver profissionais tratando crawl budget e indexação como problemas separados. Na prática, eles são inseparáveis. O Google só indexa aquilo que ele consegue rastrear, e só rastreia com prioridade aquilo que considera relevante. Quando o crawl budget é mal distribuído, a indexação se torna lenta, seletiva e, em alguns casos, simplesmente não acontece.
Imagine um site com dez mil URLs indexáveis, mas apenas mil realmente estratégicas. Se o Google gasta a maior parte do tempo visitando páginas duplicadas, filtros de busca internos, variações de parâmetros ou conteúdos rasos, sobra pouco orçamento para as páginas que importam. O resultado é um site que publica bem, mas não colhe os frutos no tempo certo.
Esse efeito é ainda mais visível em projetos de conteúdo contínuo, como blogs, portais e e-commerces. Lançamentos frequentes exigem rastreamento frequente. Se o Google demora semanas para encontrar um conteúdo novo, ele perde relevância temporal, links naturais deixam de surgir e a chance de ranqueamento diminui drasticamente.
Outro ponto crítico é a atualização de conteúdos antigos. Quando uma página já indexada recebe melhorias significativas, o Google precisa rastreá-la novamente para recalcular sinais. Sites com crawl budget saudável costumam ter atualizações refletidas rapidamente. Já sites com orçamento comprometido veem melhorias ignoradas por meses, criando a falsa sensação de que “atualizar conteúdo não funciona”.
No fundo, o crawl budget funciona como um gargalo invisível. Enquanto ele estiver estrangulado, qualquer esforço de SEO se torna menos eficiente. Quando ele flui, o site ganha agilidade estratégica.
Onde o crawl budget é desperdiçado na prática
O desperdício de crawl budget raramente acontece por um único erro grave. Ele surge da soma de decisões pequenas, muitas vezes bem-intencionadas, mas mal executadas. A maioria dos sites desperdiça rastreamento sem sequer perceber.
Um dos vilões mais comuns são URLs parametrizadas. Filtros de busca, ordenações, sessões, tracking codes e variações infinitas de parâmetros criam milhares de versões praticamente idênticas de uma mesma página. Para o Google, cada URL é uma entidade potencialmente única. Sem controle adequado, o robô tenta entender todas, gastando orçamento em páginas sem valor real.
Outro ponto crítico são páginas de baixa qualidade mantidas indexáveis. Conteúdos curtos, categorias vazias, tags sem curadoria, páginas de busca interna e arquivos de data são exemplos clássicos. Elas existem, o Google encontra, avalia rapidamente como fracas e segue em frente, mas o custo de rastreamento já foi pago.
Redirecionamentos mal planejados também drenam crawl budget. Cadeias longas, redirecionamentos temporários sem necessidade e URLs antigas nunca limpas obrigam o Google a fazer múltiplas requisições para chegar ao destino final. Em escala, isso se transforma em um ralo silencioso.
Há ainda o desperdício causado por arquitetura inflada. Menus gigantescos, links para tudo em todas as páginas, paginações profundas e ausência de priorização interna fazem com que o Google trate tudo como igualmente importante. Quando tudo é importante, nada é prioritário.
O mais perigoso desse cenário é que nada “quebra” visivelmente. O site funciona, as páginas abrem, o Search Console não acusa erros graves. Ainda assim, o desempenho orgânico patina. E a causa está no uso ineficiente do crawl budget.
Crawl Budget como ferramenta estratégica, não apenas técnica
Tratar crawl budget como um checklist técnico é um erro conceitual. Ele é, antes de tudo, um reflexo da estratégia de conteúdo e da maturidade do projeto. Sites bem posicionados não são apenas tecnicamente corretos; eles são seletivos.
Ser seletivo significa decidir, conscientemente, quais páginas merecem existir para o Google. Isso envolve escolhas difíceis: desindexar conteúdos medianos, consolidar páginas semelhantes, eliminar variações inúteis e aceitar que nem tudo precisa ser rastreado.
Um exemplo clássico aparece em e-commerces. Muitas lojas mantêm categorias duplicadas por marca, por preço, por cor, por tamanho, todas indexáveis. Do ponto de vista do usuário, algumas dessas variações fazem sentido. Do ponto de vista do Google, elas competem entre si. Um site estrategicamente orientado usa noindex, canonicalização e arquitetura interna para deixar claro quais versões são prioritárias.
Em projetos editoriais, a estratégia passa pela curadoria. Tags excessivas, criadas automaticamente, raramente geram valor. Arquivos por data quase nunca são buscados. Manter tudo indexável por medo de “perder tráfego” é, na prática, perder eficiência.
Quando o crawl budget é tratado como ativo estratégico, cada URL passa por uma pergunta simples: isso merece atenção contínua do Google? Se a resposta não for um “sim” claro, a página deve ser controlada, consolidada ou removida do índice. Essa mentalidade separa sites medianos de projetos realmente escaláveis.
Como otimizar o crawl budget sem sacrificar crescimento
O medo mais comum ao falar de crawl budget é o receio de cortar demais. Muitos projetos evitam desindexações por pânico de perder tráfego potencial. A otimização correta, no entanto, não reduz alcance; ela concentra força.
O primeiro passo é mapear o comportamento real do Google. Logs de servidor, relatórios de rastreamento e dados do Search Console mostram quais URLs estão sendo visitadas com frequência e quais são ignoradas. Essa análise costuma revelar surpresas desconfortáveis: páginas irrelevantes recebendo mais visitas do robô do que conteúdos estratégicos.
Em seguida, entra a priorização técnica. Arquivos robots.txt bem configurados evitam que áreas inúteis sejam rastreadas. Noindex aplicado com critério remove páginas fracas do índice sem bloquear completamente o rastreamento quando necessário. Canonicals bem definidos consolidam sinais e reduzem duplicidade.
A arquitetura interna precisa reforçar essas decisões. Links internos são votos de importância. Quando uma página estratégica está a quatro ou cinco cliques da home, enquanto páginas irrelevantes estão no menu principal, o Google recebe uma mensagem confusa. Ajustar essa hierarquia é uma das formas mais eficazes de redistribuir crawl budget sem perder conteúdo.
Por fim, a otimização passa pela qualidade. Sites que publicam menos, mas melhor, tendem a ser rastreados com mais frequência. Atualizações reais, melhorias perceptíveis e conteúdos que geram engajamento natural aumentam a demanda de rastreamento. O Google passa a querer voltar.
Crawl Budget em sites grandes, médios e pequenos: diferenças reais
Existe um mito persistente de que crawl budget só importa para sites gigantes. A verdade é mais sutil. O impacto é mais visível em grandes volumes, mas a lógica se aplica a qualquer escala.
Em sites pequenos, o orçamento costuma ser suficiente para rastrear tudo. O problema surge quando o projeto cresce sem controle. Blogs que começam com cinquenta posts e chegam a cinco mil, e-commerces que multiplicam categorias e filtros, plataformas que acumulam páginas de suporte. O que antes era irrelevante passa a ser um gargalo.
Em sites médios, o crawl budget começa a se tornar um diferencial competitivo. Dois projetos com autoridade semelhante podem ter desempenhos muito diferentes apenas pela forma como gerenciam rastreamento. Um indexa rápido, testa, ajusta e cresce. O outro demora semanas para reagir.
Já em sites grandes, o crawl budget é uma questão de sobrevivência. Portais de notícias, marketplaces e plataformas globais dependem de decisões extremamente refinadas para não desperdiçar milhões de requisições diárias. Nesses casos, a otimização deixa de ser pontual e se torna parte da cultura técnica.
Independentemente do tamanho, a pergunta central é a mesma: o Google está gastando tempo onde deveria? Quando a resposta é negativa, o crescimento orgânico tende a ser mais lento e caro.
O crawl budget como indicador de maturidade em SEO
No fim das contas, o crawl budget funciona como um termômetro silencioso. Sites bem organizados, com foco claro e histórico consistente, são rastreados com fluidez. Sites confusos, inflados e sem curadoria enfrentam lentidão crônica.
Observar como o Google se comporta diante do seu site revela mais do que qualquer discurso. Se novas páginas são descobertas rapidamente, se atualizações são refletidas em dias, se erros são corrigidos sem esforço excessivo, há um sinal claro de confiança.
Por outro lado, quando cada nova publicação exige submissão manual, pedidos de indexação e semanas de espera, algo está desalinhado. Muitas vezes, o problema não é o conteúdo, nem a autoridade, mas a forma como o crawl budget está sendo desperdiçado ao longo do tempo.
Projetos maduros encaram o rastreamento como um recurso finito e valioso. Eles planejam, revisam e ajustam continuamente. Não acumulam lixo estrutural. Não indexam por inércia. Cada URL existe por um motivo estratégico claro.
Dominar crawl budget é sair da mentalidade reativa e assumir controle real sobre a relação com o Google. É parar de implorar por atenção e começar a merecê-la de forma consistente.
Isso é o que fazemos na prática
Auditoria de SEO técnico
Rastreamento limpo, indexação previsível e Core Web Vitals dentro do limiar.
Ver auditoria de seo técnicoContinue por aqui
Topicality: O Guia Completo para Construir Sua Topical Authority de Verdade
Falar de topicality hoje não é mais discutir uma tendência de SEO, mas compreender uma mudança estrutural na forma como…
Interlinking: Como Distribuir Autoridade (e Melhorar SEO) Sem “Linkar Tudo”
No vasto e intrincado ecossistema da otimização para motores de busca, poucos elementos ostentam um potencial tão paradoxalmente subestimado e,…
Sitelinks Searchbox: Como a Searchbox Melhora a Navegação e o CTR
A expressão searchbox — e sua manifestação mais específica no contexto de SEO como Sitelinks Searchbox — já foi uma…