Robots.txt Sem Erros: Bloqueios Que Derrubam Tráfego (O Guia Completo)
O arquivo robots é um dos elementos mais simples e, ao mesmo tempo, mais perigosos do SEO técnico. Simples porque sua sintaxe cabe em poucas linhas.…
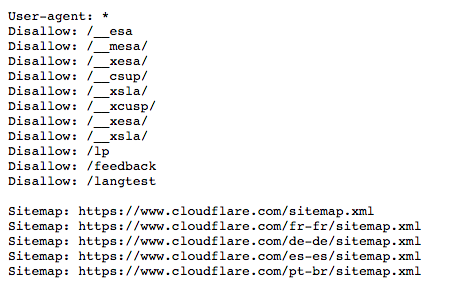
O arquivo robots é um dos elementos mais simples e, ao mesmo tempo, mais perigosos do SEO técnico. Simples porque sua sintaxe cabe em poucas linhas. Perigoso porque um único caractere mal colocado é suficiente para derrubar tráfego orgânico, desindexar áreas estratégicas e comprometer meses — às vezes anos — de trabalho. Este guia foi escrito para quem já entende a importância do rastreamento, da indexação e da arquitetura de informação, mas quer dominar o uso do robots.txt sem cometer erros silenciosos que só aparecem quando o prejuízo já aconteceu.
Robots.txt: por que um arquivo tão pequeno controla tanto tráfego
Desde os primeiros anos da web comercial, o robots.txt surgiu como um acordo de cavalheiros entre sites e mecanismos de busca. Ele não foi criado para segurança, nem para esconder conteúdo sensível, mas para orientar rastreadores sobre onde faz sentido investir recursos de crawling. O problema é que, com o tempo, o papel desse arquivo foi mal interpretado, simplificado demais ou tratado como um detalhe irrelevante.
Na prática, o robots.txt influencia diretamente três pilares críticos do SEO: orçamento de rastreamento, descoberta de URLs e eficiência de indexação. Quando você bloqueia uma pasta inteira sem entender suas dependências internas, pode estar impedindo o Google de acessar arquivos CSS e JavaScript necessários para renderização. Quando bloqueia parâmetros de URL de forma agressiva, pode estar escondendo páginas que geram conversão real. E quando libera tudo sem critério, pode desperdiçar crawl budget com lixo técnico.
O impacto raramente é imediato. Diferente de um noindex aplicado diretamente em uma página, um erro em robots costuma agir como uma corrosão lenta. O site continua aparecendo no Search Console, as páginas ainda existem, mas o tráfego começa a cair de forma difusa, difícil de diagnosticar. É nesse ponto que muitos times percebem tarde demais que o problema não está no conteúdo, nem nos links, mas em um arquivo esquecido na raiz do servidor.
Entender o robots.txt exige abandonar a ideia de que ele é apenas um bloqueador. Ele é, na verdade, uma ferramenta de priorização estratégica. Quem domina isso passa a controlar como os buscadores enxergam o site ao longo do tempo.
Erros comuns de robots que bloqueiam rastreamento sem intenção
Grande parte das quedas de tráfego associadas ao robots.txt não vem de decisões conscientes, mas de erros acumulados. Um deles é o uso indiscriminado de Disallow: / em ambientes de teste que acabam sendo replicados em produção. Outro é copiar arquivos de referência sem adaptação, prática comum em projetos com prazos curtos e múltiplos ambientes.
Um erro recorrente é bloquear diretórios que parecem irrelevantes, mas sustentam páginas importantes. Pastas como /wp-includes/, /wp-content/ ou diretórios de assets em frameworks modernos não existem para ranqueamento direto, mas são essenciais para renderização correta. Quando o Google não consegue interpretar layout, interações ou carregamento, a avaliação de qualidade da página cai — mesmo que o conteúdo esteja lá.
Outro ponto crítico envolve parâmetros de URL. Muitos profissionais tentam “limpar” o site bloqueando tudo que contém ?, acreditando estar combatendo conteúdo duplicado. O efeito colateral é bloquear filtros, paginações controladas e até URLs geradas por campanhas internas que poderiam ser úteis para descoberta. O robots.txt não diferencia intenção; ele apenas obedece padrões.
Há ainda o problema do excesso de regras específicas. Quanto mais complexo o arquivo, maior a chance de conflito lógico. Rastreadores seguem uma hierarquia clara, mas humanos nem sempre leem com o mesmo rigor. Um Allow mal posicionado pode não compensar um Disallow mais amplo acima. A sensação de controle aumenta, mas a previsibilidade diminui.
O ponto central é simples: todo bloqueio deveria existir para resolver um problema real de rastreamento, não para “organizar” o site de forma abstrata. Quando a motivação não é clara, o risco cresce exponencialmente.
Robots e orçamento de rastreamento: o equilíbrio entre liberar e restringir
Em sites pequenos, falar de crawl budget pode soar exagerado. Em sites médios e grandes, ignorá-lo é ingenuidade. O robots.txt é uma das poucas ferramentas que permitem direcionar, de forma macro, como os buscadores gastam seus recursos ao visitar o domínio.
O erro mais comum aqui é o pensamento binário: ou se bloqueia demais, ou se libera tudo. Nenhuma das abordagens é estratégica. Bloquear demais impede descoberta e atualização de páginas importantes. Liberar tudo faz o Google gastar tempo com URLs inúteis, atrasando a indexação do que realmente importa.
Um uso maduro do robots passa por mapear padrões de URLs que não geram valor: buscas internas infinitas, filtros sem demanda, combinações paramétricas que nunca recebem links externos. Esses padrões podem — e devem — ser bloqueados. Ao mesmo tempo, áreas que sustentam clusters semânticos, mesmo que não ranqueiem sozinhas, precisam permanecer acessíveis.
É aqui que muitos confundem robots.txt com outras diretivas. Se o objetivo é evitar indexação, o noindex é mais apropriado. Se o objetivo é consolidar sinais, canonicals resolvem melhor. O robots deve entrar quando a questão é rastreamento, não visibilidade direta.
Empresas que tratam o robots.txt como parte viva da estratégia técnica revisam esse arquivo sempre que a arquitetura muda. Novas categorias, novos filtros, novas tecnologias de frontend exigem reavaliação. O arquivo não é estático; ele acompanha o crescimento do site.
Controle de parâmetros via robots: quando funciona e quando destrói SEO
Controlar parâmetros é uma das tarefas mais delicadas do SEO técnico. O robots.txt oferece uma solução tentadora: bloquear tudo que parece variável. O problema é que variabilidade não significa irrelevância.
Parâmetros podem representar ordenação, paginação, filtros de preço, cor, tamanho ou localização. Alguns geram milhões de combinações inúteis. Outros concentram demanda real e comportamento de busca previsível. Tratar todos da mesma forma é um erro conceitual.
O robots.txt só entende padrões de URL, não intenção de busca. Ao bloquear *?*, você assume que nenhum parâmetro vale a pena. Na prática, isso raramente é verdade em e-commerces, marketplaces e portais grandes. Muitas páginas que capturam cauda longa dependem exatamente desses parâmetros.
Uma abordagem mais sólida envolve cruzar dados. Logs de servidor mostram o que os bots realmente rastreiam. Search Console revela quais URLs recebem impressões. Analytics indica comportamento do usuário. Só depois desse diagnóstico faz sentido decidir o que bloquear via robots e o que tratar com canonicals, noindex ou configurações específicas de parâmetros.
Profissionais experientes sabem que o robots.txt não é a ferramenta principal para controle fino. Ele é o machado, não o bisturi. Usá-lo para resolver problemas que exigem precisão quase sempre gera danos colaterais.
Robots.txt não é segurança: mitos perigosos e falsas proteções
Um dos mitos mais persistentes é acreditar que bloquear algo no robots.txt equivale a protegê-lo. Isso nunca foi verdade. O arquivo é público, acessível a qualquer pessoa, e funciona por adesão voluntária. Bots maliciosos simplesmente o ignoram.
Mesmo do ponto de vista de SEO, bloquear áreas sensíveis pode gerar o efeito oposto ao desejado. Se uma URL bloqueada recebe links externos, o Google pode indexá-la sem conteúdo, exibindo apenas o endereço nos resultados. O resultado é perda de controle da mensagem e da experiência do usuário.
Áreas administrativas, ambientes de staging, páginas de teste e APIs internas devem ser protegidas por autenticação, firewall ou regras de servidor. O robots.txt pode complementar, mas nunca substituir, essas camadas.
Outro erro comum é usar o robots para esconder conteúdo “fraco”. Isso não melhora a qualidade percebida do site. Pelo contrário: pode impedir que o Google entenda a estrutura completa, prejudicando páginas boas que dependem desse contexto.
SEO maduro não tenta esconder problemas. Ele resolve. O robots.txt entra como parte da solução técnica, não como cortina de fumaça.
Boas práticas avançadas de robots para sites modernos e escaláveis
Sites modernos são dinâmicos, dependem de JavaScript, APIs e renderização complexa. Tratar o robots.txt como nos anos 2000 é um erro estratégico. Hoje, ele precisa conversar com o stack tecnológico e com os objetivos de negócio.
Uma boa prática é documentar cada regra. Não no arquivo em si, mas internamente. Saber por que algo foi bloqueado evita decisões automáticas no futuro. Outra é testar qualquer alteração em ambiente controlado, acompanhando logs e relatórios de cobertura antes de promover para produção.
Também é fundamental alinhar o robots com sitemaps. Bloquear URLs que estão no sitemap é um sinal confuso para buscadores. O sitemap indica o que você quer que seja rastreado; o robots indica o que não deve ser. Quando os dois entram em conflito, a confiança diminui.
Empresas com múltiplos subdomínios precisam lembrar que cada um tem seu próprio robots.txt. Esquecer isso gera inconsistências difíceis de rastrear. O mesmo vale para versões internacionais e ambientes mobile específicos.
Por fim, vale lembrar que o robots.txt é uma das poucas áreas do SEO onde menos é mais. Um arquivo curto, claro e revisado periodicamente costuma performar melhor do que um conjunto extenso de regras criadas para cobrir todas as possibilidades imagináveis.
Robots como ferramenta estratégica, não como detalhe técnico
Tratar o robots.txt como um detalhe técnico é um erro de maturidade. Ele é, na verdade, uma ferramenta estratégica de comunicação entre o site e os mecanismos de busca. Quem entende isso passa a usá-lo com intenção clara, alinhada a objetivos de crescimento e não apenas de “organização”.
Os maiores desastres de tráfego causados por robots não vêm de ignorância total, mas de confiança excessiva. A sensação de que “está tudo certo” porque o arquivo existe e não gera erros visíveis é enganosa. O verdadeiro impacto se revela no longo prazo, quando páginas deixam de ser rastreadas, atualizações demoram a refletir e oportunidades de busca se perdem silenciosamente.
Dominar o uso de robots exige visão sistêmica. Envolve entender comportamento de bots, arquitetura de informação, dados reais de acesso e objetivos de negócio. Não é tarefa para checklists genéricos nem para copiar e colar soluções prontas.
Quando bem usado, o robots.txt protege o site de desperdício, orienta rastreamento eficiente e sustenta crescimento orgânico saudável. Quando mal usado, derruba tráfego sem avisar. A diferença entre um cenário e outro está menos na complexidade do arquivo e mais na maturidade de quem o escreve.
Isso é o que fazemos na prática
Auditoria de SEO técnico
Rastreamento limpo, indexação previsível e Core Web Vitals dentro do limiar.
Ver auditoria de seo técnicoContinue por aqui
Topicality: O Guia Completo para Construir Sua Topical Authority de Verdade
Falar de topicality hoje não é mais discutir uma tendência de SEO, mas compreender uma mudança estrutural na forma como…
Interlinking: Como Distribuir Autoridade (e Melhorar SEO) Sem “Linkar Tudo”
No vasto e intrincado ecossistema da otimização para motores de busca, poucos elementos ostentam um potencial tão paradoxalmente subestimado e,…
Sitelinks Searchbox: Como a Searchbox Melhora a Navegação e o CTR
A expressão searchbox — e sua manifestação mais específica no contexto de SEO como Sitelinks Searchbox — já foi uma…